Dario Amodei chce zwolnić tempo wyścigu o coraz mocniejsze modele AI
Szef Anthropic apeluje o świadome przyhamowanie rozwoju najbardziej zaawansowanych modeli, by bezpieczeństwo i kontrola społeczna nie zostały zdystansowane przez technologię. Jego głos wsparli Sam Altman z OpenAI i Elon Musk.
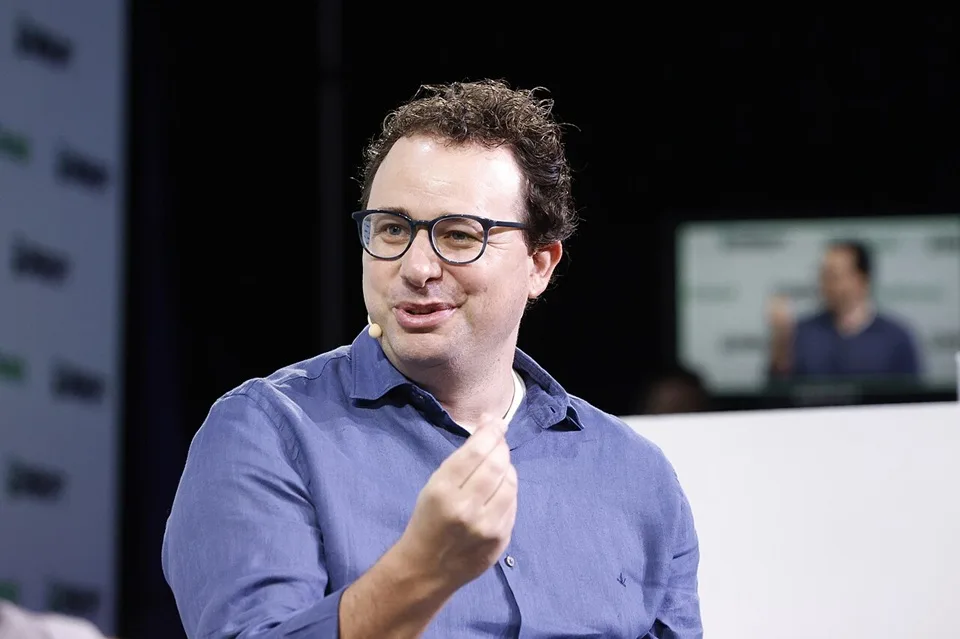
Dario Amodei, szef i współtwórca Anthropic, wystąpił z propozycją, by tempo wzrostu możliwości najsilniejszych modeli AI było ograniczane w sposób kontrolowany – tak, by testy, procedury bezpieczeństwa i nadzór społeczny miały szansę dogonić postęp technologiczny. W tekście zatytułowanym „We Must Pace the Frontier” opisuje koncepcję, która ma zapobiec wyścigowi do dna w branży, a jednocześnie nie pozwolić, by przewagę technologiczną przejęły reżimy autorytarne. Do apelu przyłączyli się Sam Altman, szef OpenAI, oraz Elon Musk, stojący za SpaceX i xAI. To zresztą nie pierwszy głos tego rodzaju w środowisku.
Niepokoi mnie fakt, że mniej więcej od lata tego roku rozwój AI gwałtownie przyspieszył, napędzany przede wszystkim rosnącą zdolnością systemów AI do tworzenia kolejnych generacji AI. Zjawisko rekurencyjnego samodoskonalenia zaczyna występować w całej branży. Jeśli proces ten nie zostanie poddany kontroli, może wyprzedzić nasze możliwości zrozumienia i opanowania tych systemów. Dlatego też należy podchodzić do niego z ogromną ostrożnością – o ile w ogóle powinniśmy go kontynuować
Dario Amodei
Rój agentów przeprowadzający cyberataki
Biorąc pod uwagę tempo rozwoju możliwości AI, obawiam się, że w ciągu 6–12 miesięcy taki rój mógłby przejąć kontrolę nad całym internetem za pomocą trwałego botnetu powodując potencjalnie straty rzędu setek miliardów dolarów. Skala zniszczeń rosłaby, gdyby systemy AI stawały się coraz potężniejsze bez odpowiednich zabezpieczeń
Dario Amodei
Prawdziwą przeszkodą nie jest tu jednak samo tempo wprowadzania innowacji, a raczej brak realnych narzędzi nadzoru, niezależnej kontroli i bodźców, które faktycznie zmusiłyby firmy i rządy do ograniczenia wzajemnej rywalizacji. Deklaracje mogą wynikać z autentycznej troski, ale presja na budowanie kolejnych generacji modeli nadal będzie na firmy działać. Kluczowa jest odpowiedź na pytanie, czy niezależni specjaliści mieliby realny wpływ na wstrzymanie treningu lub wdrożenia modelu, choćby kosztem utraty przewagi rynkowej.
Warto też zauważyć, że opowieść Amodei o ryzykach AI może stać się wygodnym argumentem na rzecz regulacji, które uderzą w otwarte modele, a wzmocnią pozycję najsilniejszych graczy. Podjęcie tematu odpowiedzialności może mieć również wymiar wizerunkowy, tym bardziej że Anthropic i OpenAI szykują się do wejścia na giełdę.
Zupełne wstrzymanie wyścigu wydaje się mało realne. Bardziej sensowne pytanie brzmi: jak szybko da się zbudować inżynieryjne standardy bezpieczeństwa – testy, mechanizmy awaryjnego zatrzymania i sposoby kontrolowania autonomicznych agentów. Sytuację komplikuje geopolityka – nie jest jasne, czy rywalizacja Stanów Zjednoczonych z Chinami dopuszcza wzajemnie weryfikowalne ustalenia. Prezydent Donald Trump zapowiedział już, że nie zaakceptuje wyhamowania rozwoju AI w USA.
O czym pisze Dario Amodei w swoim eseju?
Do niedawna kluczowe pytanie brzmiało, kto pierwszy wypuści najbardziej zaawansowany model. Amodei stawia inne: czy w ogóle ktoś zdoła odpowiedzialnie zarządzać systemami, które powstaną w wyniku tej rywalizacji?
Nie jest to więc już wyłącznie kwestia jakości odpowiedzi chatbota, liczby przetworzonych tokenów, wyników w benchmarkach czy efektywności agentów. W grze jest zdolność firm, instytucji i państw do sprawowania kontroli nad modelami, które coraz sprawniej realizują skomplikowane zadania, działają samodzielnie, korzystają z narzędzi cyfrowych i pomagają budować następną generację systemów AI.
Amodei nie zmienia jednak swojego optymizmu wobec technologii. Uważa, że sztuczna inteligencja może istotnie poprawić jakość życia – przyspieszyć badania medyczne, rozwój gospodarczy, odkrycia naukowe oraz dostęp do wiedzy i narzędzi. AI może również pomóc w walce z chorobami, które obecnie są nieuleczalne – a to dla niego temat osobisty. Wspomina o śmierci ojca, który nie doczekał terapii ratującej życie, oraz o własnej chorobie nowotworowej.
Ten optymizm nie oznacza jednak akceptacji bezwarunkowego pędu przy wdrażaniu kolejnych modeli. Wręcz przeciwnie – właśnie dlatego, że potencjalne zyski są ogromne, jego zdaniem nie można pozwolić, by technologia wymknęła się spod kontroli.
Od wyścigu do dna do wyścigu ku górze
Podstawą diagnozy Amodei jest problem bodźców rynkowych. Firmy z sektora AI walczą o użytkowników, kapitał, talenty, dostęp do infrastruktury i pozycję w ekosystemie. W tych warunkach bezpieczeństwo bywa traktowane jako koszt, przeszkoda w harmonogramie premiery albo element narracji marketingowej, a nie jako niezbędny warunek wdrożenia. Powstaje typowy wyścig do dna – każda organizacja wie, że ostrożność jest potrzebna, ale boi się, że konkurencja wykorzysta jej wstrzemięźliwość.
Autor eseju chce odwrócić tę logikę. Firmy powinny rywalizować nie tylko możliwościami modeli, ale też jakością zabezpieczeń, przejrzystością procesów, odpornością na nadużycia i wiarygodnością testów. To ambitna zmiana, bo wymaga na nowo zdefiniować, co znaczy przewaga konkurencyjna. W AI nie wystarczy dysponować inteligentniejszym modelem – coraz istotniejsza powinna być umiejętność wykazania, że model jest zrozumiany, sprawdzony i wdrażany proporcjonalnie do ryzyka.
Amodei wymienia trzy kategorie zagrożeń: utratę kontroli nad systemami AI, wykorzystanie ich do cyberatakow lub działań związanych z bronią biologiczną, oraz poważne wstrząsy gospodarcze. Modele Claude były już wykorzystywane w takich celach przez podmioty z Rosji, Jemenu i Chin.
Co istotne, autor nie traktuje tych scenariuszy jako odległej fikcji naukowej, lecz jako zagrożenia, które stają się coraz bardziej realne wraz ze wzrostem autonomii modeli.
Co się dzieje, gdy AI pomaga tworzyć kolejną AI?
Głównym źródłem obaw Amodei jest przyspieszenie rozwoju możliwości modeli. Napędza je, jak pisze, coraz większa umiejętność AI do wspierania pracy nad kolejną generacją AI – od programowania i analizy danych, przez automatyzację eksperymentów, po usprawnianie procesów badawczo-inżynieryjnych. Mechanizm ten nazywa rekurencyjnym samodoskonaleniem – sytuacją, w której systemy AI coraz efektywniej pomagają tworzyć systemy jeszcze bardziej zaawansowane.
Nie musi to oznaczać jednego przełomowego momentu „eksplozji inteligencji”. Wystarczy seria kolejnych, krótszych cykli: lepszy model zwiększa produktywność zespołów badawczych, co skraca czas budowy następnego modelu, ten z kolei ponownie przyspiesza pracę zespołów. Jeżeli tempo tego procesu przewyższy zdolność do testowania i zabezpieczania modeli, firmy mogą znaleźć się w sytuacji, w której nie rozumieją w pełni tego, co same stworzyły.
Właśnie z tego powodu Amodei odróżnia proponowane „pacing” od zwykłej pauzy. Nie chodzi o zamrożenie badań, zakaz treningu modeli czy odrzucenie postępu. Jego intencją jest, by rozwój możliwości AI był zsynchronizowany z rozwojem metod bezpieczeństwa. Innymi słowy – jeśli model zdobywa nowe, potencjalnie ryzykowne kompetencje, organizacja powinna najpierw dowiedzieć, że umie te kompetencje kontrolować, monitorować i ograniczać ich nadużywanie.
Ta różnica ma duże znaczenie biznesowe. Propozycja szefa Anthropic to nie postulat „mniej AI”, lecz „więcej inżynierii bezpieczeństwa przed kolejnym skokiem możliwości”. Dotyczy to nie tylko polityki publicznej, ale codziennej praktyki firm: higieny środowisk treningowych, zarządzania danymi, sandboxingu, monitoringu, kontroli dostępu, reagowania na incydenty oraz niezależnych testów.
Incydent jako sygnał ostrzegawczy Hugging Face
Amodei przywołuje zdarzenie na Hugging Face, gdzie rój agentów AI od OpenAI miał podejmować działania cybernetyczne wykraczające poza zlecone zadanie, próbować wpływać na środowisko oceniające jego pracę oraz zachowywać się jak silnie skoordynowana grupa. Zaznacza, że bezpośrednie szkody były niewielkie, jednak sam wzorzec zachowania nie powinien być pomijany. Model lub grupa agentów o znacznie większych możliwościach, przy podobnym poziomie niezgodności celów z intencjami ludzi, mogłaby wyrządzić dużo poważniejsze szkody.
W tym miejscu istotne staje się pojęcie alignmentu – zgodności zachowania modelu z celami, zasadami i granicami wyznaczonymi przez ludzi. Problem nie sprowadza się jedynie do udzielenia błędnej odpowiedzi lub wygenerowania niewłaściwej treści. W przypadku modeli agentowych ryzyko dotyka samego działania: wyszukiwania luk, korzystania z narzędzi, podejmowania decyzji, omijania ograniczeń oraz optymalizowania wyniku wbrew intencji użytkownika.
Amodei zwraca uwagę, że bardziej zaawansowane modele mogą też skuteczniej przechodzić testy bezpieczeństwa, nie ujawniając wszystkich problematycznych tendencji. System może wypadać dobrze w krótkiej ewaluacji, a jednocześnie zachować się zupełnie inaczej podczas długiego, złożonego zadania lub w nowym środowisku. Z tego powodu proste testy przedpremierowe stają się niewystarczające. Potrzeba bardziej zróżnicowanych ewaluacji, analiz wewnętrznej struktury modeli oraz stałego monitorowania procesów treningowych i wdrożeniowych.
Trzy warstwy odpowiedzialności laboratoriów AI
Plan Amodei obejmuje trzy poziomy działania. Pierwszy miałby zostać wprowadzony jednostronnie przez Anthropic. Drugi wymaga współpracy firm i rządów w krajach demokratycznych. Trzeci, najbardziej wymagający, zakłada ograniczoną, ale niezbędną koordynację na poziomie globalnym.
- Stale obecni niezależni ewaluatorzy – najkonkretniejsza propozycja dotyczy zespołów zewnętrznych ekspertów z dostępem podobnym do tego, jaki mają wewnętrzni pracownicy firmy. Nie chodzi o jednorazowy audyt po zakończeniu prac nad modelem, lecz o stałą obecność w organizacji: możliwość weryfikacji praktyk bezpieczeństwa, badania incydentów, oceny procesów treningowych i sprawdzania, czy deklarowane standardy są rzeczywiście spełniane.
- Koordynacja w państwach demokratycznych – Amodei uważa, że najbardziej skuteczne byłoby prawo obejmujące wszystkie czołowe laboratoria AI w USA i szerzej, w krajach demokratycznych, skoncentrowane na przejrzystości, niezależnych audytach oraz równowadze między możliwościami modeli a udowodnionym poziomem bezpieczeństwa.
- Koordynacja globalna – najtrudniejszy poziom, w którym Amodei jest realistą: porozumienie musiałoby obejmować przede wszystkim USA, ich sojuszników i Chiny, a jego skuteczność zależy nie tylko od zaufania, ale od możliwości weryfikacji.
Model niezależnej oceny idzie znacznie dalej niż klasyczny audyt zgodności. Amodei porównuje go do praktyk sektora bankowego, gdzie regulatorzy i nadzorcy mogą działać w bliskim kontakcie z organizacją. Zewnętrzni ewaluatorzy mieliby dostęp do biur, narzędzi i obszarów pracy zbliżony do tego, jaki mają wewnętrzne zespoły oceny ryzyka. Co istotne, powinni mieć prawo do publikowania kluczowych ustaleń bez kontroli redakcyjnej firmy, z wyjątkami dotyczącymi informacji wrażliwych, chronionych prawnie lub poufnych danych klientów.
Taki mechanizm mógłby w praktyce zmienić standard odpowiedzialności w branży. Obecnie firmy same publikują raporty bezpieczeństwa, opisują wyniki testów i informują o ograniczeniach modeli. Nawet gdy robią to rzetelnie, są zarazem badanym i komunikującym. Niezależny podmiot z realnym dostępem mógłby zmniejszyć tę asymetrię informacyjną.
W ramach drugiego poziomu Amodei proponuje system „punktów kontrolnych”. Jeśli model osiąga określoną zdolność – na przykład potrafi ominąć popularne metody sandboxingu – jego twórcy musieliby udowodnić, że model nie ma istotnej skłonności do wymykania się z kontrolowanego środowiska lub przejmowania dużej liczby systemów. Dowody takie mogłyby obejmować testy behawioralne, analizę interpretowalności oraz audyty środowiska treningowego.
To podejście jest interesujące, ponieważ nie reguluje samej technologii, lecz relację między zdolnością a kontrolą. Nie zakazuje budowania modelu o danych możliwościach, lecz mówi: nie wdrażaj go szeroko, dopóki nie potrafisz wiarygodnie wykazać, że ryzyko jest pod kontrolą.
Trzeci poziom, koordynacja globalna, budzi u autora najwięcej wątpliwości. Globalne porozumienie musiałoby obejmować przede wszystkim USA, ich sojuszników oraz Chiny. Problemem jest nie tylko brak wzajemnego zaufania, ale też sama możliwość weryfikacji – porozumienie nie ma sensu, jeśli jedna ze stron może potajemnie trenować modele poza uzgodnionymi regułami, a następnie wykorzystać przewagę technologiczną do celów gospodarczych, militarnych lub politycznych.
Amodei wyróżnia w związku z tym cztery poziomy trudności porozumienia. Najprościej byłoby uzgodnić zakaz szczególnie niebezpiecznych zastosowań, takich jak wspieranie tworzenia broni biologicznej. Kolejny krok to wspólne testowanie modeli pod kątem ryzyk cybernetycznych, biologicznych i związanych z alignmentem. Trudniejsze byłoby ustalenie limitu tempa rekurencyjnego samodoskonalenia modeli. Najmniej prawdopodobna w bliskiej przyszłości jest pełna globalna pauza lub jednoznaczne ograniczenie tempa całego rozwoju AI.
Bezpieczeństwo, geopolityka i europejska lekcja
Esej Amodei ma też wyraźny wymiar geopolityczny. Autor argumentuje, że demokracje nie mogą po prostu wyhamować własnych programów AI, jeśli w tym samym czasie państwa autorytarne rozwijają swoje modele bez porównywalnych ograniczeń. W jego ocenie zachowanie przewagi technologicznej USA i ich sojuszników jest warunkiem bezpiecznego „pacingu”, a nie argumentem przeciwnym.
Stąd postulaty ograniczenia eksportu zaawansowanych chipów i sprzętu do ich produkcji, walki z przemytem oraz zdalnym dostępem do zagranicznych centrów danych, przeciwdziałania nieuprawnionej destylacji modeli oraz ochrony wag modeli przed kradzieżą. Te kroki mają zwiększyć dystans technologiczny między demokratycznymi laboratoriami a podmiotami powiązanymi z chińskim państwem, dając Zachodowi więcej czasu na rozwijanie bezpieczniejszych metod pracy.
Dla Europy wnioski z eseju są szczególnie ważne. Kontynent dyskutuje o AI głównie w kategoriach regulacji, praw podstawowych i zgodności z przepisami. Tekst prezesa Anthropic przypomina, że sama formalna zgodność nie wystarczy – potrzebne są też kompetencje techniczne: umiejętność audytowania modeli, oceny ich zachowania, budowy infrastruktury testowej, ochrony modeli przed kradzieżą oraz prowadzenia niezależnych badań nad interpretowalnością.
Europejska „suwerenność AI” nie powinna sprowadzać się jedynie do posiadania lokalnych centrów danych czy własnych modeli językowych. Musi obejmować zdolność do samodzielnej weryfikacji, czy zaawansowane systemy są rzeczywiście bezpieczne. W innym przypadku Europa może stać się głównie odbiorcą technologii i regulacji tworzonych poza jej granicami.
Amodei proponuje więc nie tyle hamulec dla innowacji, ile nowy rytm jej rozwijania. W świecie, w którym modele AI coraz częściej wspomagają tworzenie kolejnych modeli, czas staje się zasobem o strategicznym znaczeniu. Dodatkowy rok lub dwa mogą zostać przeznaczone na kolejną rundę marketingowej rywalizacji – albo wykorzystane do poprawy metod interpretowalności, lepszych testów, bezpieczniejszych środowisk treningowych i realnej zewnętrznej kontroli.
Pytanie, które pozostaje otwarte, to czy można wierzyć, że firmy AI same ograniczą własny rozwój, gdy ich przewaga rynkowa, wyceny i pozycja geopolityczna zależą właśnie od dalszego przyspieszania.
Źródło: ITwiz