OpenAI znakuje teksty z ChatGPT. Na razie tylko w Unii Europejskiej
OpenAI wprowadza niewidoczny dla człowieka znak wodny w odpowiedziach ChatGPT i Codexa generowanych dla użytkowników z UE. To efekt unijnych przepisów o przejrzystości systemów AI, które weszły w życie 2 sierpnia.
Jeszcze niedawno rozpoznanie, czy dany tekst wyszedł spod ręki człowieka, czy wygenerował go model językowy, graniczyło z niemożliwością. Próby budowania detektorów treści AI kończyły się zwykle rozczarowaniem, bo ich trafność budziła poważne wątpliwości. Teraz jednak OpenAI postanowiło zmienić reguły gry, zapowiadając wprowadzenie mechanizmu znakowania odpowiedzi generowanych przez ChatGPT oraz Codexa, skierowanego do osób korzystających z tych narzędzi na terenie Unii Europejskiej.
Ślad, który zdradzi pochodzenie tekstu
Od 2 sierpnia obowiązują nowe wymogi dotyczące przejrzystości systemów sztucznej inteligencji, wynikające z unijnego AI Act. Zgodnie z nimi wybrane treści tworzone przez AI muszą zawierać oznaczenia pozwalające je rozpoznać. Chodzi o ograniczenie dezinformacji, manipulacji, podszywania się pod realne osoby oraz narastającego zalewu sieci syntetycznymi materiałami.
Regulacje nie zmuszają nikogo do umieszczania pod każdym akapitem wygenerowanym przez AI jaskrawej adnotacji informującej o jego pochodzeniu. Istotniejsza jest identyfikacja na poziomie technicznym, odczytywalna przez dedykowane narzędzia i systemy informatyczne. Oznacza to, że przeciętny czytelnik może nie zauważyć żadnej różnicy, podczas gdy odpowiednie oprogramowanie będzie w stanie wychwycić, że tekst powstał z udziałem modelu AI.
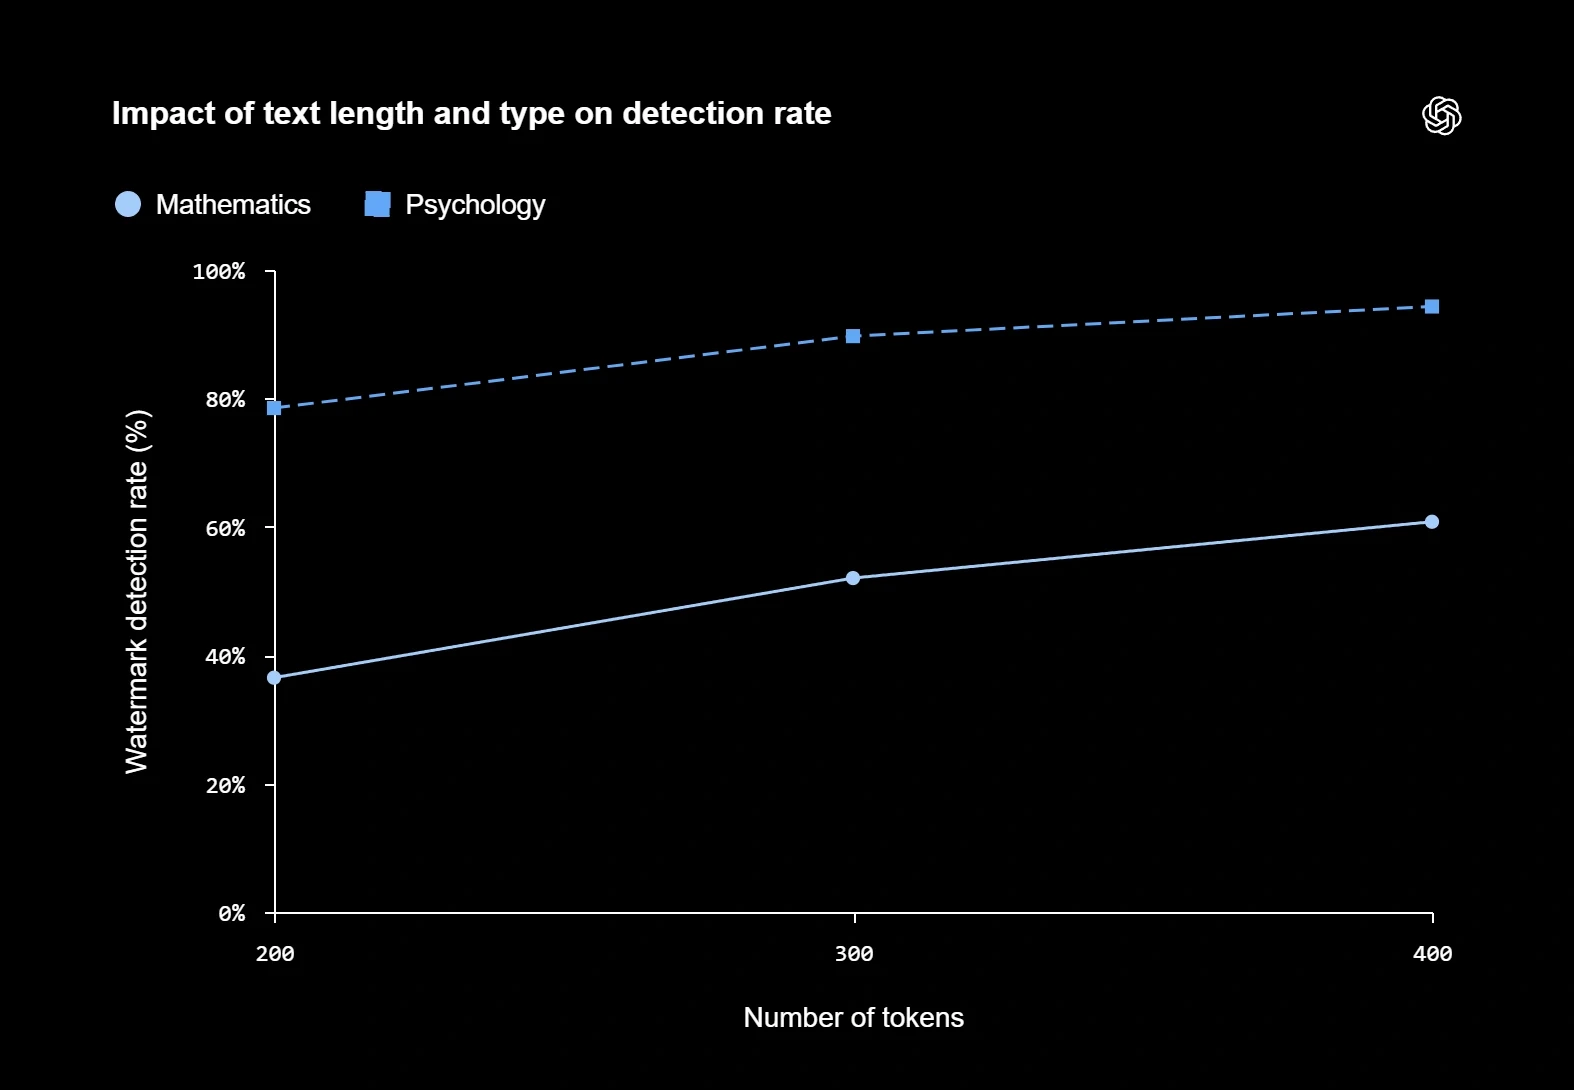
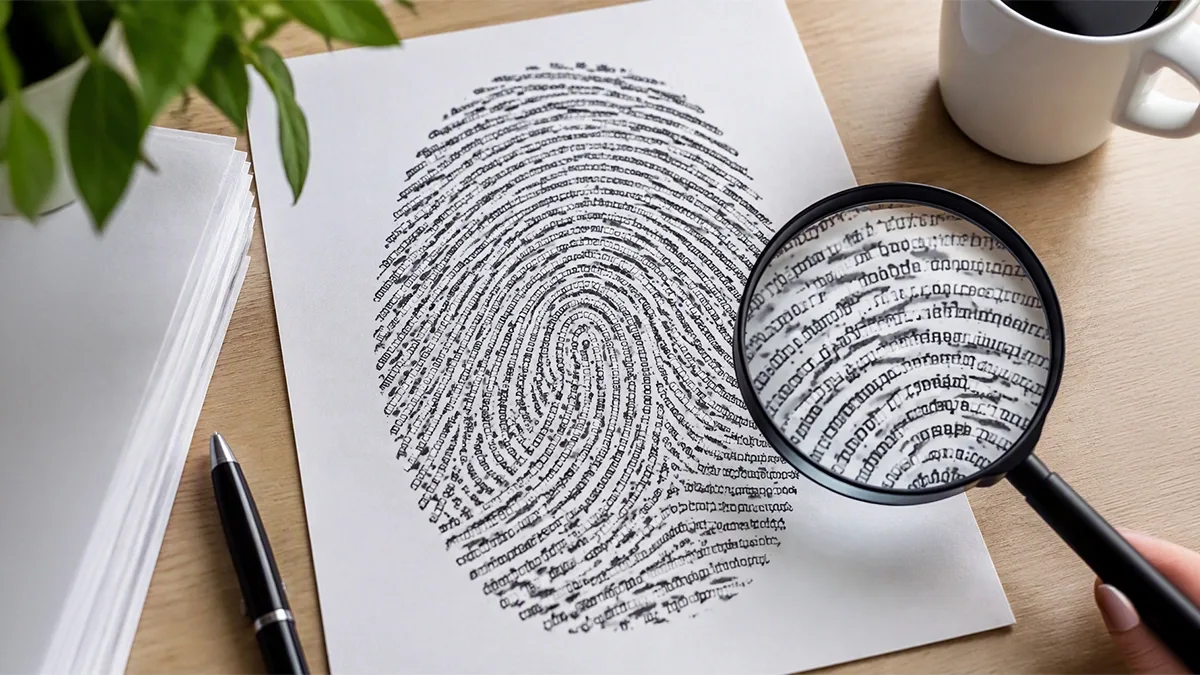
Rozwiązanie zaprojektowane przez OpenAI otrzymało nazwę textGrain. Według opisu producenta polega ono na wprowadzeniu do generowanego tekstu niewidocznego sygnału statystycznego, zaszytego w sposobie, w jaki model dobiera słowa. Osobny mechanizm detekcyjny analizuje później fragment tekstu i sprawdza, czy można w nim odnaleźć znak wodny przypisany OpenAI. Mechanizm przypomina nieco cyfrową steganografię, choć nie ma tu mowy o ukrytych znakach, dodatkowych spacjach czy nietypowych symbolach. Model po prostu subtelnie faworyzuje konkretne warianty słów albo konstrukcje zdaniowe, tworząc wzorzec, który da się odczytać właściwym narzędziem.
Kluczowe jest to, że osoba korzystająca z ChatGPT nie dostrzeże żadnej zmiany - treść ma wyglądać identycznie jak dotąd. Modyfikacja zachodzi wyłącznie na poziomie statystycznym i pozostaje praktycznie niewyczuwalna dla odbiorcy. Koncepcja nawiązuje do technik znakowania, które od dawna stosuje się w przypadku obrazów, wideo czy plików dźwiękowych. Tekst okazuje się jednak znacznie bardziej oporny - wystarczy kilka ręcznych poprawek, parafraza czy przepisanie fragmentu własnymi słowami, by skuteczność detekcji gwałtownie spadła. Z tego właśnie powodu OpenAI formułuje opis możliwości nowego systemu z dużą ostrożnością.
OpenAI nie ukrywa: to technologia daleka od doskonałości
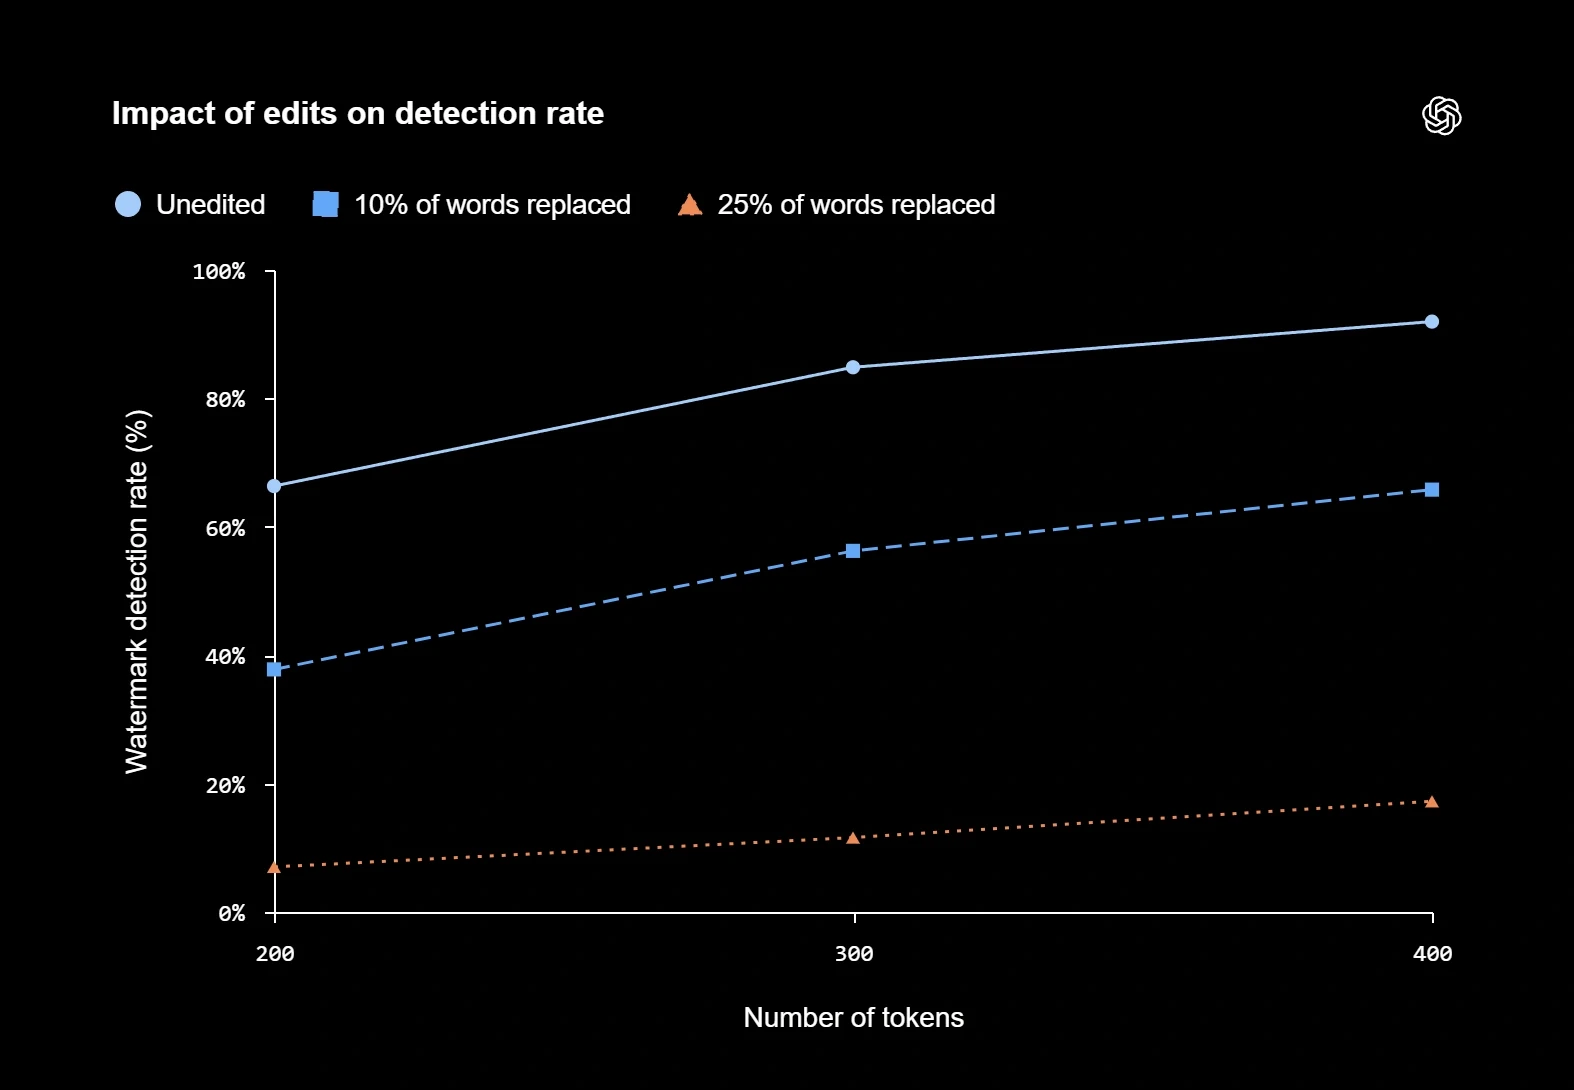
Producent wprost zaznacza, że znaki wodne w tekście to wciąż rozwiązanie na wczesnym etapie rozwoju, obarczone istotnymi ograniczeniami. Dobre wyniki osiągane w warunkach testowych nie przekładają się automatycznie na taką samą skuteczność w codziennym użytkowaniu. OpenAI zaznacza, że system detekcji może generować zarówno fałszywe alarmy, jak i przypadki, gdy sygnał zostanie przeoczony. Samo wykrycie znaku wodnego nie przesądza w żaden sposób o tym, kto jest autorem tekstu, kto ponosi odpowiedzialność za jego treść ani czy zawarte w nim informacje są prawdziwe.
To zastrzeżenie ma spore znaczenie. W publicznej dyskusji co rusz pojawiają się głosy, by „wykrywacze AI” traktować jako niepodważalny dowód użycia modeli językowych - na przykład w szkołach, na uczelniach czy w rekrutacjach. OpenAI jasno zaznacza, że technologia po prostu nie jest do tego przeznaczona. Wykrycie znaku wodnego świadczy jedynie o obecności sygnałów charakterystycznych dla systemów firmy, a nie o tym, że cały tekst napisała wyłącznie sztuczna inteligencja. Nie wyklucza to też sytuacji, w której człowiek później gruntownie zmienił treść. W praktyce taki wynik ma więc charakter poszlaki, a nie dowodu rozstrzygającego.
Czemu na razie tylko w Europie?
Przez najbliższe tygodnie niewidoczne oznaczenia mają obejmować wyłącznie kwalifikujące się odpowiedzi ChatGPT i Codexa kierowane do użytkowników z Unii Europejskiej. Równolegle osoby korzystające z API OpenAI w dowolnym miejscu na świecie będą mogły samodzielnie zdecydować, czy chcą włączyć znakowanie treści - domyślnie funkcja pozostanie wyłączona. Ta decyzja sama w sobie sporo mówi o podejściu firmy.
Znak wodny stanowi jedynie element znacznie szerszej układanki, którą w branży określa się terminem „provenance”, czyli śledzenie pochodzenia treści. OpenAI od pewnego czasu pracuje nad technologiami umożliwiającymi identyfikację obrazów, nagrań dźwiękowych i innych materiałów tworzonych przez AI, wykorzystując między innymi standard C2PA, pozwalający zapisywać metadane opisujące źródło pliku.
Dla przeciętnego internauty temat może wydawać się mało porywający, lecz w perspektywie kilku lat może stać się jednym z kluczowych technologicznych pól walki z dezinformacją. Sieć coraz bardziej przypomina przestrzeń, w której niemal każdy obraz, nagranie, film czy tekst może być dziełem maszyny. Rozpoznawanie treści „na wyczucie” przestaje się sprawdzać, dlatego potrzebne są mechanizmy umożliwiające ustalenie źródła materiału, zanim trafi on do mediów społecznościowych, wyszukiwarki czy komunikatora.
Kłopot w tym, że żadne z dostępnych rozwiązań nie jest doskonałe. Metadane da się usunąć, znaki wodne można próbować obejść, a teksty - przepisać i sparafrazować. Z tego powodu cała branża poszukuje dziś raczej zestawu uzupełniających się metod niż jednego uniwersalnego sposobu identyfikacji treści tworzonych przez AI. Jak na razie - bez większego powodzenia.
Źródło: Spider's Web