Procesory zdradzają sekrety przez własny mechanizm przewidywania skoków
Badacze opisali nową metodę ataku o nazwie Branch Target Reuse, która wykorzystuje nieaktualne wpisy w buforze przewidywania skoków procesora. W praktyce pozwala to odzyskać dane, które z punktu widzenia systemu dawno przestały istnieć.
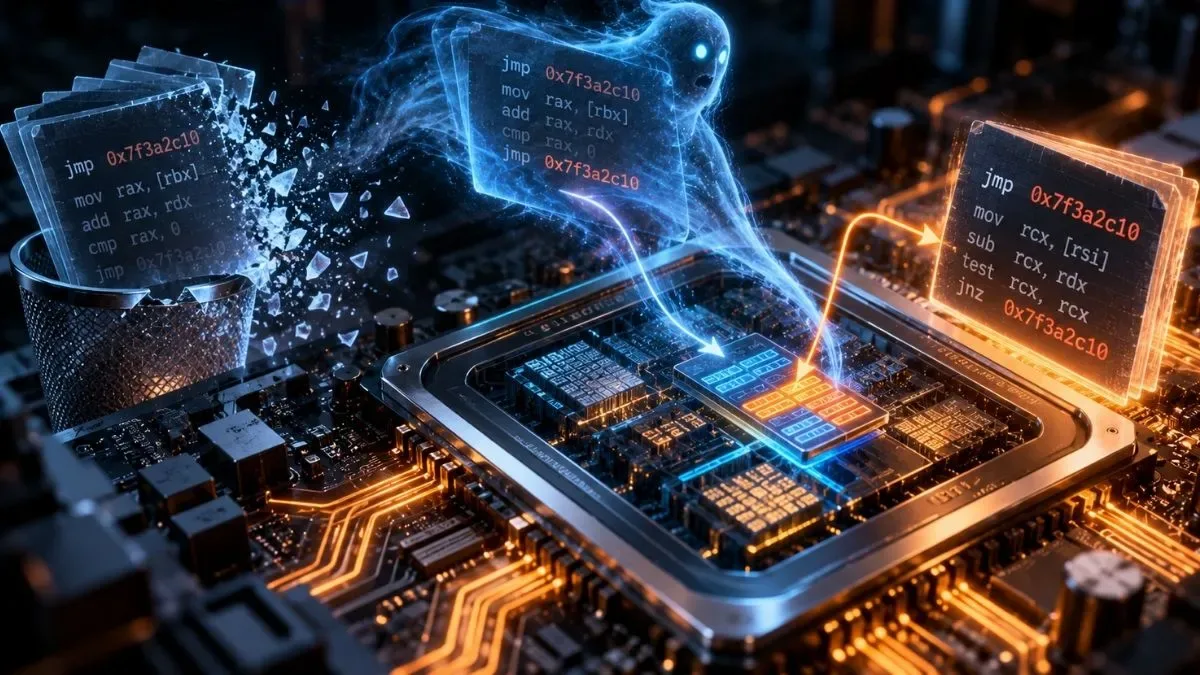
Procesor wykonał kod wygenerowany przez program, potem ten fragment został usunięty z pamięci i z perspektywy systemu operacyjnego przestał istnieć. Problem w tym, że jeden z komponentów jednostki centralnej wciąż go "pamiętał". Mechanizm przewidywania skoków zachował informację o tym, pod jaki adres wcześniej warto było przekierować wykonanie programu.
Kiedy w to samo miejsce w pamięci trafił później całkiem inny kod, procesor na moment skorzystał z przestarzałej prognozy i zaczął wykonywanie dokładnie tam, gdzie w normalnych warunkach nigdy nie powinien się znaleźć. Taki krótki epizod okazał się wystarczający, by pozostawić po sobie trop umożliwiający wydobycie danych objętych ochroną.
Zespół naukowców z Vrije Universiteit Amsterdam oraz Scuola Superiore Sant'Anna opisał tę technikę jako Branch Target Reuse - ponowne użycie celu skoku. Opracowanie pod tytułem Branch Target Reuse: Practical Spectre-v2 Attacks in JIT Engines via Stale Branch Prediction Entries zostało zaakceptowane do programu konferencji ACM CCS 2026.
Procesor zgaduje, dokąd program za chwilę pójdzie
Aby pojąć istotę tego ataku, warto wrócić do koncepcji, która w 2018 roku zaowocowała odkryciem podatności Spectre. Wysoka wydajność dzisiejszych procesorów wynika między innymi z tego, że nie zawsze oczekują na zakończenie poprzedniej operacji - podejmują próbę odgadnięcia dalszego przebiegu programu i z wyprzedzeniem rozpoczynają realizację kolejnych instrukcji. Trafna prognoza oznacza zysk czasu, błędna - odrzucenie wyników spekulatywnych obliczeń.
Rzecz odkryta w związku ze Spectre polegała na tym, że pozostałości po takiej nieudanej spekulacji mogą utrzymać się choćby w pamięci podręcznej procesora. Osoba przeprowadzająca atak jest w stanie je potem zmierzyć i na tej podstawie odtworzyć informacje, do których nie powinna mieć dostępu.
Skutki Spectre i Meltdown Spider's Web opisywał już w 2018 roku. Od tamtej pory producenci procesorów i systemów operacyjnych wprowadzili szereg mechanizmów obronnych utrudniających takie ataki. Branch Target Reuse jednak dociera do tego samego źródła problemu, lecz zupełnie inną drogą.
Kod JIT pojawia się i znika cały czas
Centralną rolę odgrywają tu kompilatory JIT (just-in-time), stosowane m.in. w przeglądarkach internetowych, maszynach wirtualnych, środowiskach uruchomieniowych, a także w jądrze Linuksa. Ich funkcja to tworzenie kodu maszynowego na bieżąco, w trakcie pracy programu. Kiedy jakiś fragment kodu JavaScript jest wywoływany wyjątkowo często, silnik przeglądarki może zamienić go na postać rozumianą prosto przez procesor. Gdy taki fragment staje się zbędny, zostaje usunięty, a zajmowany przez niego obszar pamięci trafia do ponownego użycia.
System w tym momencie traktuje stary kod jako nieistniejący, a procesor widzi już nową treść danego miejsca w pamięci. Nie zawsze jednak zanika historia zapisana w buforze przewidywania celów skoków (BTB). Procesor bywa w stanie wciąż utrzymać informację: przy poprzednim wykonaniu tego skoku, trafiałem pod taki właśnie adres. I to jest punkt wyjścia dla całego ataku.
Branch Target Reuse przebiega w kilku etapach. Na początku atakujący wymusza na JIT wygenerowanie fragmentu kodu i wielokrotnie uruchamia odpowiedni skok, przez co trenuje mechanizm przewidywania na konkretny cel. Następnie ten fragment kodu zostaje usunięty.
JIT w kolejnym kroku przydziela ten sam obszar pamięci dla nowego programu. Gdy skok zostaje wywołany po raz kolejny, procesor może odwołać się do nieaktualnego wpisu w BTB i spekulatywnie skoczyć pod zapamiętany wcześniej adres - mimo że w tym miejscu znajduje się już zupełnie inna zawartość.
Dodatkowym utrudnieniem jest to, że procesor może trafić w środek jakiejś instrukcji i odczytać jej bajty w sposób całkowicie odbiegający od zamierzonego. Badaczom udało się tak skonstruować nowy kod, aby z błędnego punktu wejścia powstał fragment przydatny do przeprowadzenia wycieku danych. Autorzy porównują to do spekulatywnego odpowiednika błędu typu use-after-free - stary cel skoku przetrwał dłużej niż kod, do którego pierwotnie kierował.
Wyciągnęli hash hasła roota w kilka minut
Najbardziej spektakularny pokaz możliwości tej techniki przygotowano w Linuksie, posługując się klasycznym BPF. Badacze zbudowali dwa programy cBPF działające jako filtry seccomp. Pierwszy miał za zadanie wyszkolić mechanizm przewidywania procesora. Po jego usunięciu w to samo miejsce trafiał drugi program, skonstruowany tak, by stare przewidywanie umożliwiło spekulatywne uruchomienie kodu odpowiadającego za wyciek informacji.
Tempo odczytu pamięci w tym ataku wyniosło około 8 bajtów na sekundę. Choć wartość ta wydaje się niewielka, trzeba pamiętać, że hasła czy klucze kryptograficzne nie zajmują gigabajtów. Zespół badawczy uruchomił komendę su root, co umieściło hash hasła w pamięci odpowiedniego procesu, a następnie za pomocą BTR zlokalizował go i odczytał. Na rdzeniach Intel Raptor Cove operacja ta zajęła około 3 minut, a na nowszych układach Lion Cove - około 5 minut. Wykradziono więc nie samo hasło w czystej formie, lecz jego hash zapisany w pamięci, który może stać się punktem wyjścia do kolejnego etapu ataku.
Pełny exploit dla Linuksa powstał na procesorach Intela, ale samo zjawisko zostało sprawdzone na szerszej grupie układów. Nieprawidłowe zachowanie dało się zaobserwować na każdym testowanym procesorze - reprezentujących rodziny Intela, AMD i Arm. Zdaniem autorów badania żaden z dzisiejszych procesorów nie synchronizuje automatycznie stanu kodu z wcześniej zapisanymi przewidywaniami celów skoków.
Przetestowano również SpiderMonkey, czyli silnik JavaScriptu i WebAssembly wykorzystywany przez Firefoksa. W tym przypadku wykazano, że stare wpisy BTB faktycznie utrzymują się po usunięciu danych i ponownym przydzieleniu pamięci. Badacze oceniają, że możliwy tu wyciek mógłby sięgać dziesiątek bajtów na sekundę, choć nie opracowali jeszcze pełnego ataku możliwego do przeprowadzenia ze złośliwej strony internetowej.
Trzecim badanym środowiskiem był Oracle GraalVM. Tu technika BTR umożliwiała spekulatywne obejście zabezpieczenia, które ogranicza dostęp programu do pamięci jego własnej piaskownicy. Skonstruowanie pełnego exploita komplikowały jednak inne operacje środowiska, które przypadkowo usuwały wpisy niezbędne dla predyktora.
Łatki już są, ale problem jest głębiej
Warto zaznaczyć, że nie mamy do czynienia z sytuacją, w której dopiero teraz ujawniono niezałataną podatność, a każdy komputer stoi w obliczu bezpośredniego ryzyka. Badacze poinformowali producentów o problemie z wyprzedzeniem. Linux otrzymał poprawki oznaczone jako CVE-2026-64507 oraz CVE-2026-64508. Gdy obszar pamięci przeznaczony dla kodu BPF trafia do ponownego wykorzystania, system jest już w stanie wyczyścić odpowiednie przewidywania procesora przy pomocy mechanizmu IBPB.
Oracle ograniczył ryzyko ataku poprzez losowanie lokalizacji pamięci wykorzystywanej przez kod JIT. Mozilla z kolei kontynuuje prace nad wzmocnieniem izolacji stron i analizuje dodatkowe środki zabezpieczające. Z praktycznego punktu widzenia najważniejsze jest regularne aktualizowanie systemu operacyjnego i przeglądarki. Znacznie istotniejszy wniosek dotyczy jednak projektantów procesorów - osiem lat po pierwszym ujawnieniu Spectre znów się okazuje, że błędna spekulacja dotycząca dalszego przebiegu wykonania programu może pozostawić po sobie coś, czego programista w ogóle nie jest w stanie zauważyć.
Źródło: Spider's Web