Mniej prób, więcej rozsądku - polski naukowiec przyspiesza uczenie robotów
Michał Nauman, laureat Nagrody im. Witolda Lipskiego 2026 i badacz w Nomagic, tłumaczy jak jego praca nad uczeniem ze wzmocnieniem skraca robotom drogę do sensownych zachowań i dlaczego samo skalowanie modeli nie rozwiąże problemu alignmentu.
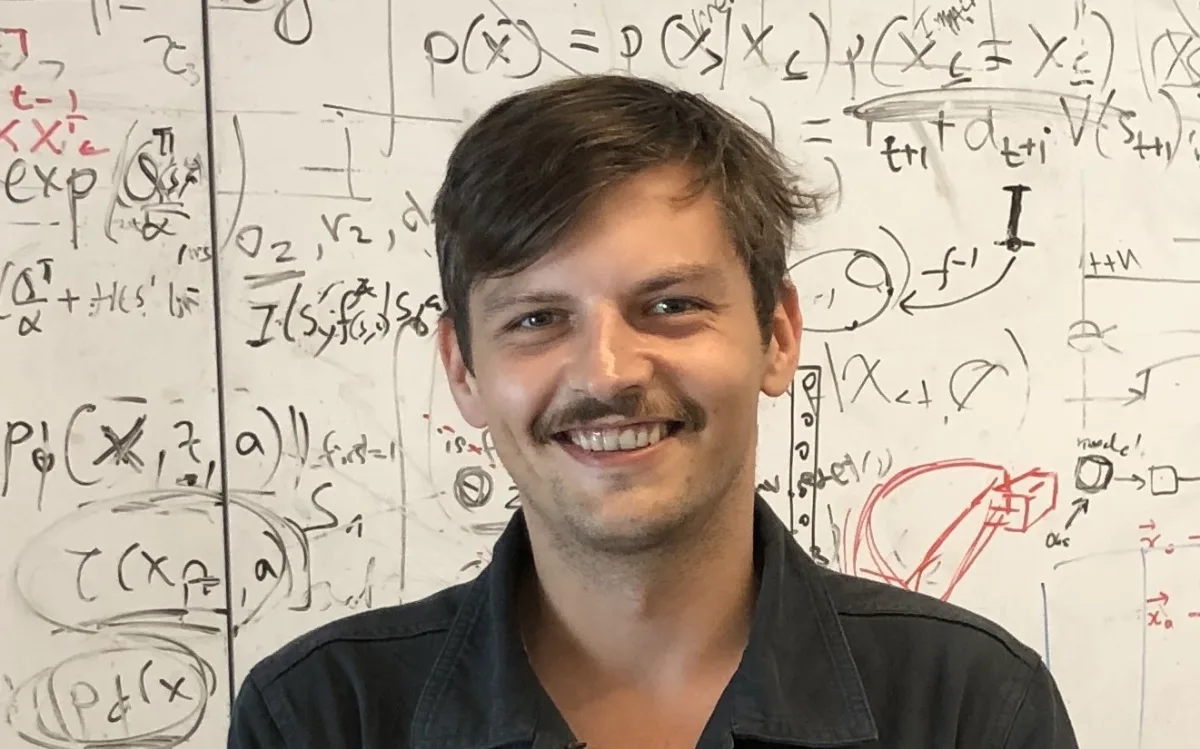
Michał Nauman, tegoroczny laureat Nagrody im. Witolda Lipskiego oraz Senior Machine Learning Researcher w Nomagic, opowiada o tym, jak jego teoretyczne odkrycia w dziedzinie głębokiego uczenia ze wzmocnieniem przyspieszają trening robotów. W rozmowie pojawia się również wątek jednoczesnego uczenia wielu zadań oraz pytanie, czy samo zwiększanie mocy obliczeniowej wystarczy, by systemy AI działały zgodnie z ludzkimi intencjami i wartościami.
Szybsza nauka oznacza mniej niebezpiecznych prób
Badacz zaznacza, że mimo powszechnej dziś mody na skalowanie, uczenie ze wzmocnieniem w wydaniu, którym się zajmuje, ma jeden nadrzędny cel - maksymalne skrócenie czasu nauki systemu. Chodzi o to, by maszyna nie musiała przechodzić przez tysiące interakcji z otoczeniem, zanim zacznie zachowywać się racjonalnie, bo każda taka próba niesie ryzyko zarówno dla samego robota, jak i dla ludzi znajdujących się w jego pobliżu - szczególnie zanim inżynierowie dopracują jego działanie.
Kluczowym rezultatem zespołu jest zwiększenie efektywności algorytmów, które teraz wymagają znacznie mniej kroków i kontaktu z realnym środowiskiem, by osiągnąć poziom działania zakładany przez projektanta. Choć sam wynik ma charakter algorytmiczny, jego zastosowania są bardzo szerokie - od szkolenia robotów po sterowanie elektrowniami. Rozwiązanie zostało już wchłonięte przez środowisko naukowe i wykorzystane w wielu projektach. Nauman był bezpośrednio zaangażowany w budowę humanoidalnego robota, który potrafi chodzić i podnosić się z ziemi.
Porównaliśmy naszą architekturę, wyróżnioną nagrodą Spotlight, z podejściem klasycznym i powtórzyliśmy wynik: robot zaczął zachowywać się w sensowny sposób w znacznie krótszym czasie i przy znacznie mniejszej liczbie interakcji z otoczeniem.
Michał Nauman
Za ulepszeniami stoją realne oszczędności
Nauman nie ukrywa, że za jego badaniami stoi konkretny aspekt finansowy. Trening modeli uczenia maszynowego pochłania dziś ogromne sumy, więc każda poprawa, dzięki której duży model uczy się szybciej, przekłada się na mniejsze zużycie prądu i akceleratorów. Sama publikacja stała się dobrem powszechnym, ale kierunek, w jakim zmierza, ma wyraźny potencjał komercyjny - może stać się podstawą biznesowych pomysłów konkurencyjnych na rynku.
Wiele zadań naraz daje efekt synergii
Zamiast uczyć robota pojedynczej czynności, zespół postawił na trening wielu zadań jednocześnie. Przykładem jest robotyczna ręka, którą chciano nauczyć chwytania przedmiotów o różnych kształtach. Trenowanie jej osobno dla każdego kształtu, z oddzielnym kodem dla każdego przypadku, wydawało się marnotrawstwem - wiele kształtów ma bowiem cechy wspólne, a ludzie posługują się podobnymi, podstawowymi ruchami niezależnie od formy przedmiotu.
Jak przyznaje badacz, zanurzenie robota w wielu zadaniach naraz może pozornie prowadzić do chaosu, z którego trudno się wydobyć. W praktyce jednak, przy odpowiednio skonfigurowanym procesie i dużej sieci neuronowej, wyszukiwanie wspólnych elementów między zadaniami daje bardzo silny efekt, który z nawiązką rekompensuje dodatkową złożoność. Odnajdywanie uniwersalnych strategii działających w różnych warunkach pozwala modelowi szybciej znaleźć właściwe rozwiązanie.
Nauman podaje przykład robota uczącego się wyłącznie stania - taka umiejętność może być mało odporna na zakłócenia, wystarczy lekkie popchnięcie, by maszyna się przewróciła. Jeśli jednak trenuje się jednocześnie stanie i bieganie, nauka biegu wytwarza pojęcie równowagi i balansu, które przekłada się na stabilniejszą postawę stojącą. Mimo większej złożoności jednoczesnego trenowania wielu zadań, poszukiwanie wspólnych mianowników naprowadza model na lepsze rozwiązania szybciej niż trening pojedynczych umiejętności.
Logistyka zamiast chwytania na AGH
Pytany o to, czy jego badania mogłyby wspomóc prace naukowców z AGH nad lepszym chwytaniem przedmiotów przez roboty, Nauman wyjaśnia, że obecnie pracuje w Nomagic, firmie rozwijającej roboty do zastosowań logistycznych. Szczegóły ewentualnej współpracy z AGH trzeba by dopiero ustalić, ale deklaruje otwartość na kontakt z polskimi naukowcami.
Publikacja zamiast patentu
Na pytanie, czy na wynikach jego badań mogą zarobić najwięksi gracze z branży AI, Nauman odpowiada, że wyniki badań naukowych z natury trafiają do domeny publicznej i tak właśnie powinno być, bo na tym opiera się tempo rozwoju całej dziedziny. Sam algorytm to jego zdaniem tylko przepis - prawdziwa wartość tkwi w doświadczeniu i intuicji zdobywanych latami pracy, czyli w wiedzy o tym, co sprawdza się w praktyce, czego unikać i jak przenieść wynik z laboratorium do działającego systemu. Tego nie da się skopiować z publikacji, dlatego uważa ten kierunek za bardzo obiecujący, a osoby się nim zajmujące mają dobre perspektywy nawet w największych firmach AI.
Zapytany, czy to nie oznacza, że najwięksi gracze korzystają z takich badań bez żadnej zapłaty dla ich autorów, odpowiada, że bezpośrednio rzeczywiście nic z tego nie dostają, ale taki jest model nauki i ma on swoje zalety.
Otwarta publikacja buduje rozpoznawalność, a za nią idą zaproszenia do współpracy, granty i propozycje pracy. Często właśnie od tych największych graczy.
Michał Nauman
Dodaje przy tym, że młodzi naukowcy już na etapie doktoratu powinni świadomie decydować, co publikować od razu, a co lepiej najpierw zabezpieczyć - choć wielu z nich na tym etapie kariery jeszcze o tym nie myśli.
O patentowaniu swoich wyników Nauman mówi, że publikacja i uznanie wkładu były świadomym wyborem, bo zależało mu na widoczności polskiej nauki na najważniejszych światowych konferencjach. Nie wyklucza jednak, że w przyszłości rozważy ochronę kolejnych rozwiązań, jeśli pojawi się ku temu sensowna okazja - jest przekonany, że to nie ostatnia wartościowa rzecz, jaką jego zespół wypracuje.
Skalowanie nie załatwi alignmentu
W ostatniej części rozmowy pojawia się temat alignmentu, czyli dostosowania działania systemów AI do ludzkich celów i wartości. Z badań Naumana wynika, że większa moc obliczeniowa nie musi przekładać się na szybszy przyrost kompetencji. Zapytany o opinię modelu językowego, który stwierdził, że wzrost liczby GPU i centrów danych nie zwiększy szansy na prawidłowy alignment, bo pozwoli jedynie powielać te same błędy na większą skalę, Nauman przyznaje, że to interesujące pytanie.
Przypomina, że w wielu obszarach rozwoju AI badacze zostali całkowicie zaskoczeni - dobrym przykładem są modele językowe. OpenAI opublikowało niedawno szereg prac matematycznych, choć jeszcze 30 lat temu nikt nie podejrzewałby, że najskuteczniejszą drogą do rozwiązania konkretnego problemu matematycznego będzie sztuczna inteligencja oparta na kompetencjach językowych, a niekoniecznie stricte matematycznych. Jego zdaniem jest w tym pewna osobliwość - najkrótsza droga do danego problemu wcale nie musi polegać na bezpośrednim skupieniu się na nim, co było zresztą osią jego własnego wykładu: skalowanie bywa niespodziewanie skutecznym lekarstwem.
Są jednak problemy, których samo skalowanie nie rozwiąże, a alignment najprawdopodobniej do nich należy. Jest on tak ściśle powiązany z możliwościami modelu, że nie można zakładać, iż poprawi się automatycznie wraz z ich wzrostem.
Zgadzam się co do zasady: nie spodziewałbym się, że alignment będzie rozwiązany samym skalowaniem. Moim zdaniem alignment wymaga pracy stricte nad alignmentem.
Michał Nauman
W rozmowie pada też nawiązanie do tezy, że obecne modele są trenowane w sposób zbliżony do kształtowania psychopatycznych wzorców i że uzyskanie alignmentu wymaga zmiany metody treningu. Przywołane zostają słowa Kuby Pachockiego, Chief Scientist w OpenAI, który stwierdził, że modele trzeba nauczyć nas kochać, bo bez tego alignment jest raczej niemożliwy, a błędne wagi powstają już na etapie treningu. Nauman ocenia tę perspektywę jako ciekawą i zawierającą ziarno prawdy, zaznaczając, że ludzkość zaczyna żyć w realiach trudnych do pełnego zrozumienia pod względem konsekwencji.
Być może musimy świadomie wprowadzać wartości w sam proces treningu, a nie liczyć, że same się jakoś pojawią.
Michał Nauman
Droga naukowa
Michał Nauman obronił w czerwcu 2026 roku na Uniwersytecie Warszawskim doktorat zatytułowany Sample-Efficient Actor-Critic Algorithms in Reinforcement Learning, napisany pod opieką prof. Marka Cygana. Wcześniej studiował na Uniwersytecie Amsterdamskim oraz odbył staż w laboratorium Petera Abbeela na UC Berkeley. Jego prace, w tym ta wyróżniona statusem Spotlight na konferencji NeurIPS, koncentrują się na tym, jak uczynić uczenie ze wzmocnieniem bardziej oszczędnym pod względem liczby interakcji z realnym środowiskiem. Obecnie Nauman pracuje jako Senior Machine Learning Researcher w Nomagic, firmie budującej roboty dla logistyki magazynowej.
Źródło: ITwiz